Define la frecuencia de los análisis
Configura cada escáner con un modo rápido y otro más profundo. El análisis estático incremental sobre los archivos modificados puede terminar en segundos y debería ejecutarse con cada commit. El análisis completo del repositorio, que puede tardar desde varios minutos hasta horas según el tamaño del código, puede ejecutarse cada noche o antes de una versión. Sus hallazgos deberían incorporarse al backlog, no bloquear automáticamente el build.
Las pruebas dinámicas necesitan la misma separación. Un análisis autenticado y dirigido únicamente a los endpoints modificados puede ejecutarse después de cada despliegue. Un rastreo completo con payloads de inyección activa no, por lo que conviene programarlo semanalmente sobre un entorno estable. Los entornos temporales de previsualización también pueden servir, siempre que el escáner pueda autenticarse y el entorno permanezca disponible el tiempo suficiente para completar la prueba.
Proporciona al escáner el contrato de tu API en lugar de confiar en que descubra todos los endpoints por sí solo. Y sé especialmente cuidadoso con producción. Las pruebas dinámicas activas envían payloads diseñados para modificar el estado del sistema, por lo que ejecutarlas contra servicios reales puede provocar corrupción de datos o interrupciones. La monitorización pasiva y el análisis de la superficie de ataque sí tienen cabida en producción. Las pruebas activas, no.
También conviene tener en cuenta la urgencia. El DBIR de 2025 concluyó que las organizaciones tardaban una mediana de 32 días en corregir por completo vulnerabilidades en dispositivos perimetrales, y que el 22% de los intentos de explotación se dirigía contra dispositivos perimetrales y VPN, aproximadamente ocho veces más que el año anterior.
Por eso, la frecuencia de las pruebas en servicios expuestos a internet merece más atención que en sistemas exclusivamente internos. Tu planificación de SAST y DAST debería reflejar esa diferencia de riesgo.
Gestionar los hallazgos
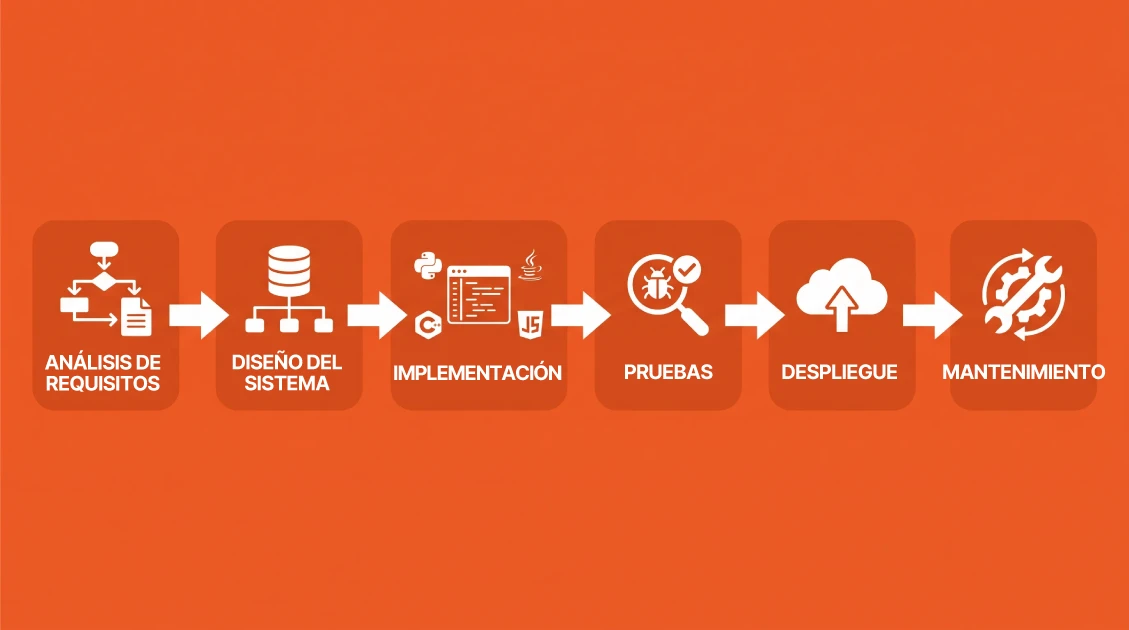
Los escáneres generan un gran volumen de datos. Un buen proceso de gestión convierte ese volumen en una lista reducida de problemas que los responsables han confirmado como reales y que se asignan a alguien capaz de solucionarlos. Sin ese proceso, la inversión en SAST y DAST acaba convirtiéndose en una cola que nadie revisa y los desarrolladores terminan ignorando un pipeline en rojo.
Asigna responsables para la revisión
Antes de ejecutar el primer análisis deben quedar definidos tres roles. La separación de responsabilidades importa más que los nombres concretos de los puestos:
-
Seguridad se encarga de validar y eliminar duplicados. Confirma que el hallazgo sea real y asigna el nivel de riesgo teniendo en cuenta su posibilidad de explotación y la criticidad del activo, en lugar de aceptar automáticamente la gravedad indicada por el escáner.
-
Ingeniería se responsabiliza de la corrección y del feedback. Si un hallazgo es incorrecto, el ingeniero explica por qué y ese razonamiento se convierte en una regla de exclusión o en un ajuste del análisis, no en un simple comentario dentro de un ticket.
-
Producto decide qué riesgos se aceptan. Aceptar temporalmente un riesgo para cumplir una fecha de lanzamiento es una decisión de negocio, por lo que debe tener un responsable identificado y una fecha de caducidad.
Los falsos positivos recurrentes son un problema de configuración. Si el mismo patrón se descarta tres veces, modifica la regla. Los equipos que no hacen este ajuste acaban llegando a un punto en el que los desarrolladores empiezan a ignorar o silenciar todos los avisos, y ese es precisamente el comportamiento que debes evitar.
Establece controles de lanzamiento
Bloquear una versión por cualquier hallazgo es la forma más rápida de conseguir que los controles terminen desactivándose. Bloquea únicamente cuando exista una combinación suficiente de gravedad y posibilidad real de explotación. El resto debe pasar al backlog con un responsable y una fecha de resolución.
Diferencia también entre problemas nuevos y problemas heredados. Un equipo que asume un servicio legacy no puede corregir diez años de vulnerabilidades antes de publicar una solución urgente. El control debería impedir que el nuevo cambio introduzca regresiones, mientras que el backlog histórico se reduce mediante un plan específico y calendarizado. Los controles compensatorios también son válidos, siempre que existan realmente y estén documentados.
La posibilidad de explotación es lo que permite priorizar con criterio. FIRST señala que la proporción de vulnerabilidades conocidas que llegan a explotarse durante un periodo de 30 días se mantiene en porcentajes bajos de un solo dígito, y que corregir automáticamente todo lo que tenga una puntuación CVSS igual o superior a 7 puede desperdiciar el 96% del esfuerzo.
Cualquier excepción al proceso debe quedar documentada por escrito, con una justificación y una persona responsable de aprobarla.
Define los SLA de corrección
Asigna plazos según la gravedad y ajústalos después en función del contexto. La directiva BOD 22-01 de CISA estableció un plazo de dos semanas para vulnerabilidades confirmadas como explotadas y divulgadas a partir de 2021, una referencia razonable para cualquier sistema expuesto a internet.
-
Explotación activa o inclusión en el catálogo KEV: trátalo como una incidencia, no como un ticket, y escálalo al responsable del servicio y al responsable de ingeniería ese mismo día.
-
Activos expuestos a internet: reduce a la mitad el plazo que aplicarías a un hallazgo equivalente en un sistema interno.
-
Correcciones de alta complejidad: mantén el plazo, pero exige una medida temporal documentada si la solución definitiva va a superarlo.
-
Riesgo aceptado: debe tener una fecha límite y revisarse de nuevo cuando llegue su vencimiento.
Haz seguimiento de la antigüedad de los hallazgos, no solo de su cantidad. Un backlog con 400 problemas de baja gravedad y ninguno fuera de plazo es más saludable que otro con 40 hallazgos donde seis llevan abiertos un año. El escalado debería ser automático cuando se incumpla el SLA y llegar a alguien con capacidad para asignar presupuesto y recursos.
Revisa el plan de pruebas
Deja por escrito qué cubre cada capa de pruebas y quién se responsabiliza de revisar los hallazgos. Si alguno de esos puntos no está documentado, se estará decidiendo de forma improvisada por la persona que esté de guardia en ese momento.
Evolved Ideas ha desarrollado y dado soporte a software para organizaciones como Bridgestone y el NHS, y nuestros ingenieros trabajan dentro de los pipelines de entrega de nuestros clientes en procesos de pruebas y publicación.
Habla con nuestro equipo sobre cómo revisar las pruebas de seguridad a lo largo de todo el ciclo de vida y definir correctamente la cobertura de SAST y DAST.